一致性检查,就是新的验证器
第一届一致性检查原理研讨会(SCCP)纪要
9 月 4 日,在波士顿的一间宴会厅里,十篇论文加一场主题演讲,构成了第一届一致性检查原理研讨会(SCCP),与 VLDB 同期举办。第一届研讨会在社会学意义上是件大事:那是一群原本散落在不同社区——数据库、操作系统、分布式系统、形式化方法——的研究者,忽然认定他们一直在做的其实是同一件事的时刻。我想把我认为的那件事写下来,也想说说为什么我相信,它将比今天重要得多。
并发世界的心智模型
先从心智模型说起,因为后面的一切都是它的特例。若干实体读写某份共享状态。没有人能直接盯着那份状态;一个观察者拿到的,是一份历史——一串操作,以及它们返回的值。问题在于:这份历史,是否可能由一个遵守其所声称规则的系统产生?
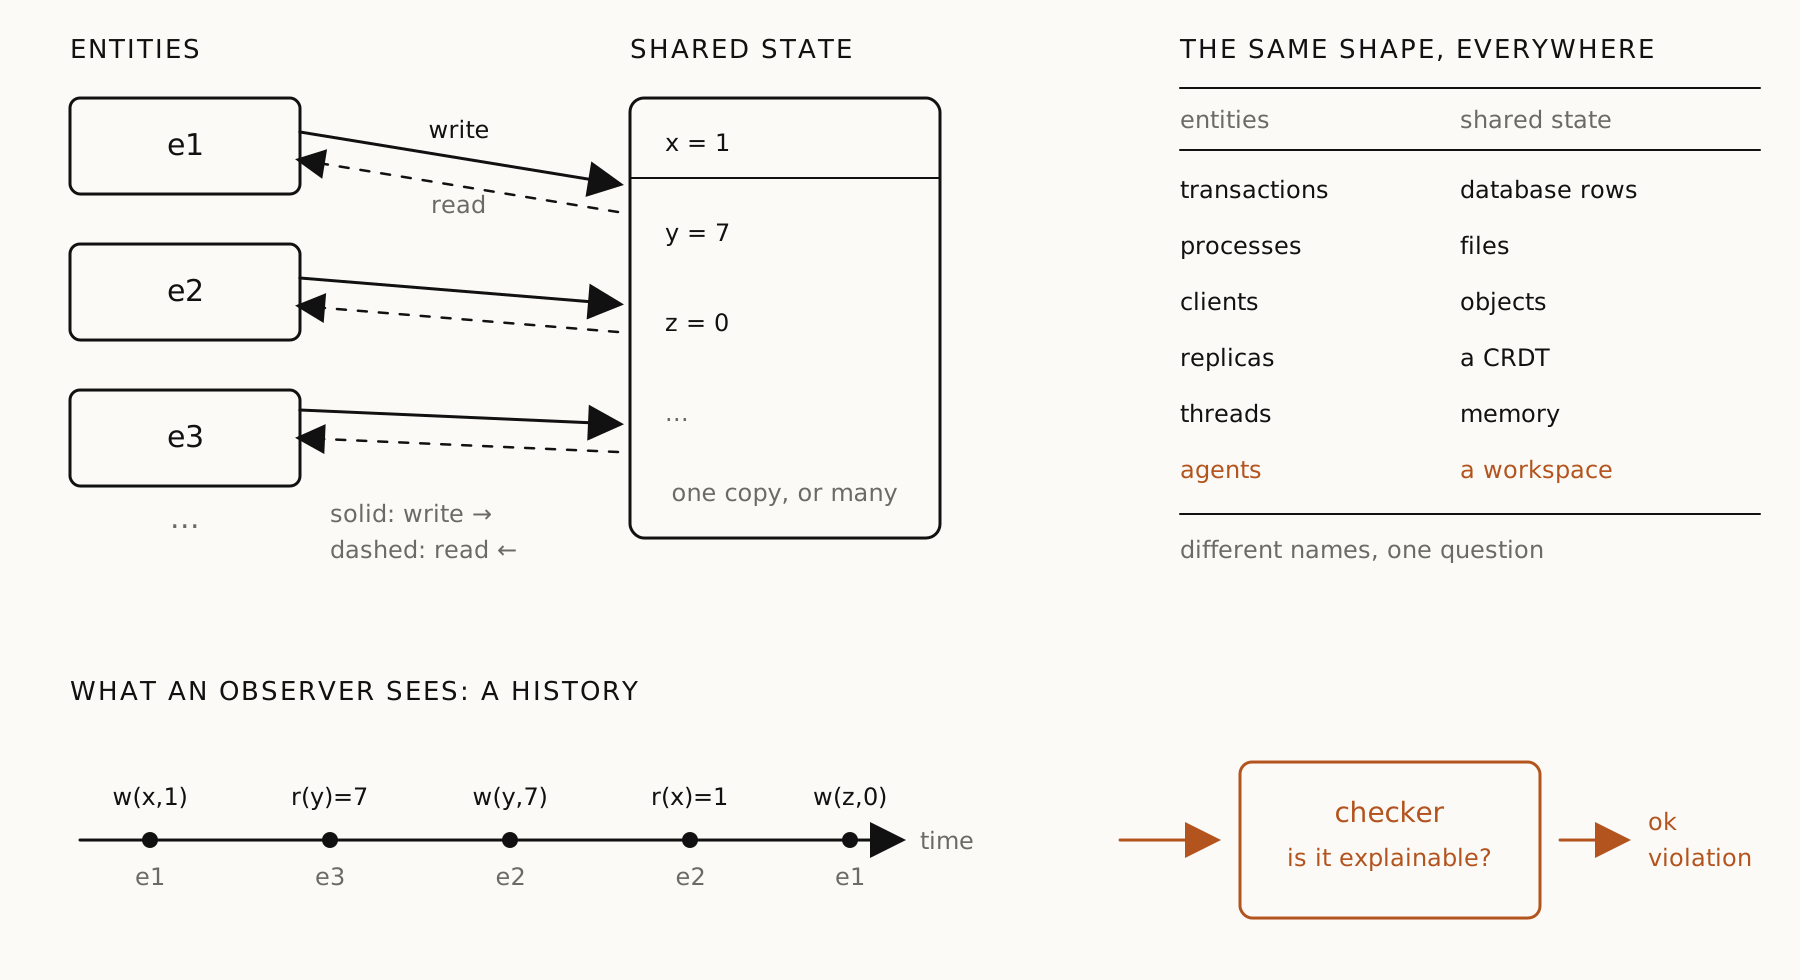
把实体和状态换个名字,你就得到了不同的系统。事务与数据库中的行。进程与文件。客户端与对象存储里的对象。副本与 CRDT。线程与内存。以及如今,智能体与一块共享的工作区。规则的名字也在变——可串行化、快照隔离、线性一致性、因果一致性——但底下那个问题始终未变:是否存在一个合法的执行,能够解释我们所看到的一切?读过先前那篇的读者会认出这个形状;那正是正确性的存在性定义,而一致性检查,是它最古老、也最具体的一个实例。
定义(大体)已经完成;检查才刚刚开始
三十年来,这个领域里最难、也最有声望的工作是下定义,以及把定义兑现:精确地说清楚快照隔离究竟意味着什么,再设计一套比上一代更高效的协议去实现它。这件事大体做完了。定义存在,而且是形式化的;协议也存在,而且其中许多已经顶到了可被证明的极限。
没做完的是检查它们。给定一个真实系统跑出来的真实历史,判断它是否满足某个级别。这个问题裂成两个都很硬的半边。理论的那半:复杂度是多少,能不能绕过去?工程的那半:怎样让检查快到足以跑在生产数据库上,而不只是玩具上?这个领域已经学到,这两者不是同一个问题,解决其一并不解决其二。只有把两半合起来,才会得到一个人们日常用得上的检查器。
错误不可避免,而且是无声的
有两股力量,正把一致性检查从一个小众关切推向中心。
第一股是复杂度的叠加。一致性级别之所以越来越弱、越来越古怪,是因为”弱”能卖出性能;而实现之所以越来越精巧,是因为容错与优化要求如此。一个现代分布式数据库,就是一个由精巧协议实现出来的弱保证——而这恰恰是错误既不可避免、又极难察觉的那种配置。
第二股是自动化,它更让我担心。随着 AI 写下越来越多的代码,能真正理解并发在做什么的人会越来越少——那种推理:为什么这个交错没问题,而那个交错是场灾难。而一致性缺陷,恰恰是过去要靠这种推理才抓得住的一类,因为一致性违例不会让任何东西崩溃。 没有堆栈回溯。系统照常在线、照常服务流量,只是悄悄持有一份任何正确执行都产生不出来的状态。一边让能看出这件事的人变少,一边让制造它的代码变多——这个组合,若没有会检查的机器,不会有好结局。
如果这听上去像学院派的忧虑,那场主题演讲就是回答。来自 IMDEA、并在 AWS 兼职的 Alexey Gotsman 讲的正是亚马逊内部如何测试分布式数据库的一致性——包括把 Aurora Limitless 这类生产系统的一次运行,重放到一个非分布式的参照实现上比对。世界上规模最大的那些数据库运营者,此刻正在生产环境里做检查。这个社区尚未成形,对它的需求却已经存在。
从几百个事务,到(接近)生产速度
这段弧线一句话就能说完。2020 年之前,黑盒隔离级别检查器的评测规模是几百个事务量级的历史。那是研究原型的规模,不是数据库的规模。随后,一致性检查跨进了实用:Cobra——我参与过的工作——能以每秒数千个事务的速度,为黑盒数据库验证可串行化,也就是说,已经接近真实系统产生事务的速率。
接下来发生的事,让我认为这是一个真正的领域。十几个课题组正在推进一致性检查的前沿,我请 Claude 整理了一份结果矩阵。回头读它,最打动人的是:进展已经变得寻常。弱级别如今有了可靠且完备的检查器。NP 难的那些,被求解器、被向数据库索要自身时间戳的灰盒设计、被换取线性时间的负载限制,一一在真实规模上拿下。吞吐量从每份历史几百个事务,爬到了每秒数万。而那些把这些工具挡在真实负载之外的假设——不支持谓词、不允许重复值、不处理范围查询——正被一篇一篇论文逐个解决,相对上一代几个数量级的加速也正在发生。这就是一个领域开始动手建造时的样子。
两个方向:向深处,与向广处
我看到这个社区有两个方向,而它们需要不同的人。
向深处。 任何拥有共享状态的系统都在射程之内,而最近的一道边界,是支持真实 SQL 的数据库:谓词会让本来便宜的级别也变贵,而能处理真实查询负载的黑盒检查器,眼下还并不真正存在。排在它后面的,是文件系统——接口与一致性模型都别扭;是对象存储——没有事务,保证还弱;是 CRDT;以及云里那片不起眼的中段——队列、消息传递、元数据服务——没人检查,人人信赖。
向广处。 智能体负载注定是并发且高度协作的,而它带着一个棘手的转折:根本没有可供检查的规范。多个智能体会读写共享的上下文、工具与记忆,而这种场景下的”正确”,尚未被定义。社区已经注意到了——十篇论文中有两篇关于 LLM 智能体,包括那篇最佳论文《Notified Serializability》,它为并发智能体提出了一个一致性模型。这里的第一反应会是去够可串行化及其亲属,而这个反应是一个好的开始,绝不是终点。
一致性检查,就是新的验证器
我相信,一致性检查远比它今天看上去要宽广,理由如下。在机器学习里,当下真正奏效的技术是”带可验证奖励的强化学习”(RLVR)——用一个确定性的检查器代替学出来的奖励模型去训练,这也是数学与代码最先获得提升的原因:它们有验证器。而系统正确性大体上没有,并发正确性更是其中最难的一例:一种没有任何测试套件能可靠捕获的性质,而承载它的代码,正越来越多地由机器写就。一个一致性检查器,就是并发正确性的验证器;而当它快到足以待在一个循环里的那一刻,它就不再只是调试工具,而成了一个正确性信号。
向前看,如果系统变得自动化且量身定制——AI 原生意义上的:系统会重写自己的实现,每一个都为自己的负载而生,带着自己的协议和自己被削弱的保证——那么通用的检查器将不再合身,检查也必须随之定制。检查器按系统逐个生成,由那些写出这些系统的同一批机器生成,而它们本身又需要被检查。这个刚刚开完第一届研讨会的领域也许会发现,它真正的工作不是造那个检查器,而是造那个”造检查器的东西”。
参考文献
-
SCCP 2026:第一届一致性检查原理研讨会. 与 VLDB 2026 同期,波士顿,2026 年 9 月 4 日。 (program and papers)
-
Ranadeep Biswas and Constantin Enea. On the Complexity of Checking Transactional Consistency. OOPSLA 2019.
-
Cheng Tan, Changgeng Zhao, Shuai Mu, and Michael Walfish. Cobra: Making Transactional Key-Value Stores Verifiably Serializable. OSDI 2020.
-
Isolation checker matrix. 黑盒隔离级别检查器对照表,2019–2026,由 Claude 整理。
-
Hongtao Lyu, Dingyan Zhang, Mingyu Wu, Xingda Wei, and Haibo Chen. Notified Serializability: A Consistency Model for Concurrent LLM Agents. SCCP 2026(最佳论文)。
-
Nathan Lambert et al. Tulu 3: Pushing Frontiers in Open Language Model Post-Training. arXiv:2411.15124, 2024(RLVR 一词的出处)。