它管用吗?
一个算法,一个被植入的 bug,以及「拿读者当神谕」的限度
关于推理的论证很廉价,所以我搭了一个最小的、足以让这一个当场出丑的实验:取一个十五行的算法,把它证明两遍(一遍写成自然语言推理步骤构成的图,一遍在 Rocq——也就是原来的 Coq——里机械化),然后比较。
这个算法是求最长无重复字符子串的滑动窗口扫描。一个左指针,一个运行中的最大值,一张从每个字符到它最后位置的表。全程没有任何花招,外加一个扛起全部正确性论证的守卫条件:如果当前字符曾在左边界上或其后出现过,就把左边界移到那次出现的下一位。
同样十五行的两份证明
第一份证明有十六个节点,S1 到 S16,每个都是一次小推理,两三条前提,一条结论,一句简短的理由。边是带类型的,类型标明一条结论如何被复用:作为直接前提,作为归纳假设,作为分情形的一支(两支由选言消去汇合),作为归纳的基础情形或归纳步,或者作为最终判决的一个合取项。在结构上它就是一份霍尔证明——一条不变式,一个基础情形,一个在”上次出现位置查表”上二分的归纳步,以及一次把结果组合进后置条件的推论规则。
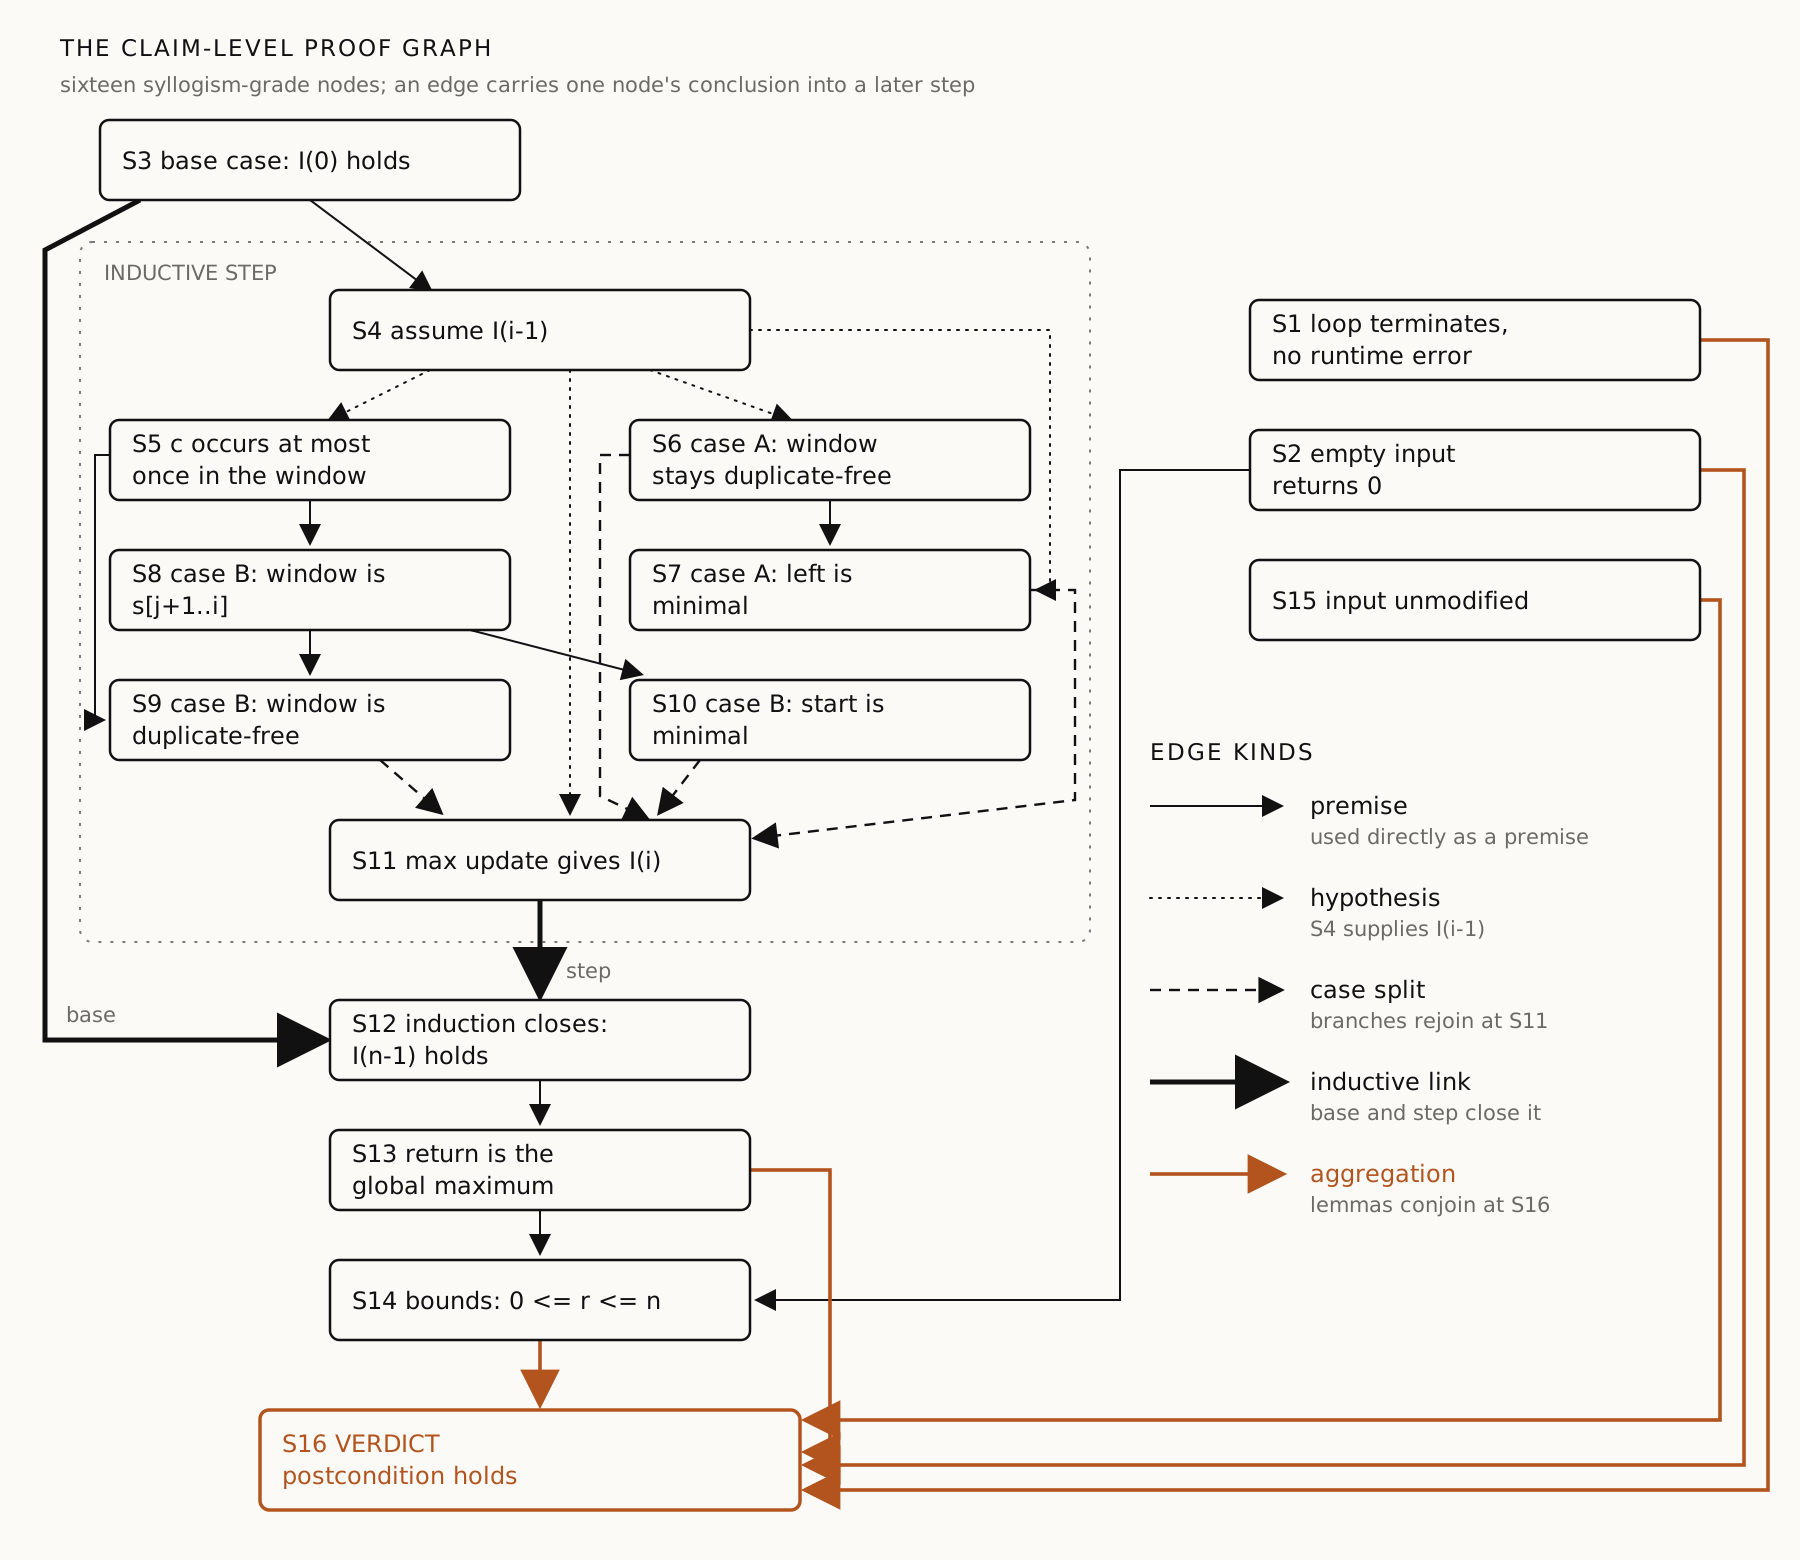
第二份证明在 Rocq 里确立同一个定理,没有公理,也没有任何一处留作待证。它以 445 行对上算法的十五行,大约二十九比一,分布在 29 条具名引理中,经过四轮编译调试才落地。
比较下来有三个结果,而其中只有一个是预料之中的。
这张图是一份好提纲。那份 Rocq 证明基本上是照着 S1 到 S16 自顶向下一遍写成的,而不变式的七个合取项,几乎逐字就是图里归纳步的那些节点。结构以接近零的代价跨过了语言边界——如果”中项纪律”真的不在乎你工作在哪一层,你预期的正是这个。
形式化没有在图里发现错误。四轮调试全是策略与记账层面的活,而不是对推理的修改。证据很薄,但它提示:一张守纪律的图可以充当形式证明实用的初稿。
这张图预言了难点。Rocq 代码里大约 42% 是下标与列表的记账,没有哪个评审者会对它起疑。概念上的难处落在图所指的位置上:极大性,也就是”左指针是最小的、而不只是合法的”这条义务。这暗示了一套工作流。把图留作主产物,只对那两三个高风险节点做形式化。
一个例子。而且是由提出主张的人自己挑的。这一点我后面会回来说。
被植入的那个 bug
一份你打不破的证明不是证据,所以我把守卫条件削弱了一个字符。出问题的版本只在此前那次出现严格位于左边界之后时才推进左边界,而不是在其上或其后。
当那个更早的字符恰好坐在左边界上时,这就出错了:窗口里留下一个重复字符,报出的长度可能偏大。在 "aa" 上,有 bug 的程序报出 2,尽管 "aa" 里根本没有长度超过一的无重复子串。
这张图标出了那个守卫条件节点。它的理由里早已点明这个边界是要害——在任何人动这段代码之前,它就白纸黑字地写着:严格比较会恰好在这种情形下没能推进指针。接着反例阶段不再讲道理,直接把程序跑起来。判决:REFUTED,附带一条失败的断言和一个被执行过的见证。
这是一个定位结果,不是可靠性结果,而定位恰恰是那两样常规工具都给不了你的。测试说有什么地方不对。经机器检查的证明说哪儿都没错。而一张证明图说出在哪里,用一句评审者读得懂的话——这正是德米洛、利普顿与佩利斯所说验证所缺的那条性质。它是一条消息。
那个不对称
把这套实现从头走一遍,最让我心里一震的并不是某个测量值。而是:哪些阶段需要模型,哪些不需要。
生成那张图需要一个,判断一个节点是否跟从它的前提也需要一个。但检查每一条前提引用是否都能解析、每条规则是否拿到了它声明的元数、叶子是否只落在前置条件或程序自身的语义上:这些全都是普通的确定性代码。反例阶段同样不征求任何人的意见。它在从前置条件中抽取的输入上运行程序,并与一个可执行的判定器比对。
由此得到那个核心的不对称:REFUTED 是可靠的;PROVED 不是。反例是事实,因为程序真的跑过了。而一个肯定的判决是一摞判断,一摞判断的好坏恰好取决于其中最差的那一个。一套有用的系统还需要第三个取值 INCONCLUSIVE,以及一条规则:绝不悄无声息地放行。
我认为这该进标题,而不是进注意事项。这就是那个让测试有用、也让”没有失败的测试”毫无意义的不对称,只多了一点:在这里,否定的结果是带着地址来的。
研究怎么说
有两个系统正在以”一个例子够不着”的规模做这件事的不同版本。它们都来自上海交大的 IPADS,并且共享一位作者,所以它们是一个组下的注,而不是两个组的不谋而合。
FM-Agent 挪动的是检查这一步:四个系统、277,000 行代码,约两天,找出 522 个新 bug,回路里没有求解器。聪明的地方不在推理,而在规约。FM-Agent 是自顶向下、从每个函数的调用者那里导出它的契约的,这样有 bug 的实现就没法把自己洗成自己的规约。那唯一一组消融是值得记住的数字:从实现导出的规约找到 57 个 bug,从调用者导出的规约找到 339 个。
这些数字需要小心。那 522 条是挺过了一道过滤器的报告;没有公开的误报率,而且四个系统里有两个,过滤器眼中的”预期行为”来自一份机器写的规约。作者们声明放弃的恰恰是该放弃的:”我们并不宣称 FM-Agent 可以取代现有的形式验证工具。”
SpecFS 与之相邻但不同。一份多部分的自然语言规约,把前置/后置条件与 rely-guarantee 契约当作书写纪律,生成了大约 4,300 行 C,分布在 45 个模块里;结果在 754 个 xfstests 中失败 64 个。没有任何东西是经机器检查的:所谓验证,是回归测试加上第二个模型评审第一个模型的产物。一句话:FM-Agent 用语言模型换掉了证明器,SpecFS 用语言模型换掉了程序员,而只有前者是一个关于验证的主张。
这套配方在数学里也不新鲜。伪形式化(把一份证明拆成模块,各自独立检查,再汇总)今年已经发表,并且胜过把整份证明丢给一位裁判:在召回率持平的前提下,被误标的步骤少了约 60%。它自己报告的局限才是说明问题的那条:两个验证器仍然漏掉了大约一半已知的错误。把论证拆开有帮助;它并不能让裁判变得可信。
基准上的图景是真正混杂的。在竞赛数学中由专家标注的步骤错误上,前沿的批评者模型能达到大约 86.5% 的步骤级平衡准确率,而且验证的成功率一贯高于求解的成功率——检查比生产容易,这是这整条路线的经济学前提,而它看来成立。但把自然发生的错误换成对抗性的(循环论证、看似相关实则无关的步骤、蓄意的欺骗),最好的分数就掉到 68.8%,而随机猜的地板是 50。判决也不稳定:在简单的反驳压力下,裁判会有 25% 到 71% 的比例改口。
最糟的结果在最后。当一份解答以无效的推理抵达正确答案时,前沿模型抓出它的成绩低至 48%,在一个二选一的问题上低于随机,而人类相对于自己解题只掉了大约六个百分点。其机制是被测量出来的,而不是猜的:一种答案确认偏差,模型去核对那个正确答案,而不是逐步检查。把最终答案的表征改一下,判决就翻转。
这恰恰就是一次节点检查的形状:你把一条结论交给裁判,问它前提是否交付了这条结论,而裁判看得见答案。对此的回应是架构上的,不是修辞上的:能用确定性检查的地方就用,把被判断的步子压小到判断仍然可靠的区间之内,并且绝不给出一个光秃秃的通过。
这套东西可以往哪里去
第一个用例不在形式验证早已兴盛的地方。而在设计文档或代码评审里那些寻常的论证:为什么这次重试是安全的,为什么这个队列是有界的,为什么这个缓存保持一致。没有人会为其中任何一条去写一份 Rocq 规约。在那里,证明图的替代品不是 Lean;而是根本没有任何被检查过的论证。
还有三个。证明的维护:被验证系统的成本中心不是第一份证明,而是代码改动之后的第二份;一张图可以逐节点重新检查,并报告这次改动让哪些断言失效了——而这正是 200,000 行 Isabelle 没法体面地告诉你的事。分块评审:一份把自己的论证作为图一并交付的设计文档,可以在第 7 个节点上被反对,而不是被整体批准或整体打回。评审研究:我在别处论证过,我们这个领域的验证阶段才是瓶颈,而它慢的部分原因在于,一篇论文的论证没法分块检查。
这笔账
它到底压在什么上面,平白地写出来:一个手挑的算法。一个检查器,它本身就是个语言模型,在最接近节点检查的那个设定里有一条被测出来的 48% 的地板。先行工作已经报告漏掉了一半的错误。以及一套系统,它唯一站得住的判决是否定的那一个。
最后这一条读起来像是在泄气,而我想以拒绝它作结。这一步断了,而这个输入证明它断了——对于一段用自然语言写下的论证,这比今天任何工具能给的都多。它是局部的,可读的,是你能照着动手的;而且不像那 200,000 行证书,你可以在走廊上把它说出口。
参考文献
- Haoran Ding, Zhaoguo Wang, and Haibo Chen. FM-Agent: Scaling Formal Methods to Large Systems via LLM-Based Hoare-Style Reasoning. arXiv:2604.11556, 2026.
- Qingyuan Liu, Mo Zou, Hengbin Zhang, Dong Du, Yubin Xia, and Haibo Chen. Sharpen the Spec, Cut the Code: A Case for Generative File System with SysSpec. FAST 2026.
- Slim Barkallah, Luke Bailey, Kaiyue Wen, Mohammed Abouzaid, and Tengyu Ma. Pseudo-Formalization for Automatic Proof Verification. arXiv:2605.20531, 2026.
- Shrey Pandit, Austin Xu, Xuan-Phi Nguyen, Yifei Ming, Caiming Xiong, and Shafiq Joty. Hard2Verify: A Step-Level Verification Benchmark for Open-Ended Frontier Math. arXiv:2510.13744, 2025.
- Chujie Zheng, Zhenru Zhang, Beichen Zhang, Runji Lin, Keming Lu, Bowen Yu, Dayiheng Liu, Jingren Zhou, and Junyang Lin. ProcessBench: Identifying Process Errors in Mathematical Reasoning. ACL 2025.
- Mingyang Song, Zhaochen Su, Xiaoye Qu, Jiawei Zhou, and Yu Cheng. PRMBench: A Fine-Grained and Challenging Benchmark for Process-Level Reward Models. ACL 2025.
- Mingzhong Sun, Teresa Yeo, Armando Solar-Lezama, and Tan Zhi-Xuan. An Enigma of Artificial Reason: Investigating the Production-Evaluation Gap in Large Reasoning Models. arXiv:2606.01462, 2026.
- Justin Zhao, Himaghna Bhattacharjee, Hannah Korevaar, Bhaktipriya Radharapu, and Khalid El-Arini. Jagged Judges: Epistemic Stability Under Perturbation, Pressure, and Persistence. arXiv:2608.12645, 2026.
- Sergiu Bursuc, Theodore Ehrenborg, Shaowei Lin, Lacramioara Astefanoaei, Ionel Emilian Chiosa, Jure Kukovec, Alok Singh, Oliver Butterley, Adem Bizid, Quinn Dougherty, Miranda Zhao, Max Tan, and Max Tegmark. A Benchmark for Vericoding: Formally Verified Program Synthesis. arXiv:2509.22908, 2025.
- Richard A. De Millo, Richard J. Lipton, and Alan J. Perlis. Social Processes and Proofs of Theorems and Programs. Communications of the ACM 22(5), 1979.