词元逻辑
保留霍尔的结构,换掉断言语言,然后检查小步子
霍尔逻辑留了一处有意为之的空缺。它的推论规则问的是一个断言是否蕴含另一个,而五十年来,答案一直由形式逻辑和一个判定过程给出。更好的求解器,更好的策略,更好的自动化,而这处空缺的形状始终没变。
现在设想换个东西去填它。三元组留着,不变式留着,组合规则留着。但把断言写成句子,并让”一句话是否跟从另一句话”的裁判,是一位读者。
这已经不是思想实验了。上海交大的 FM-Agent”把霍尔逻辑的推理规则推广到自然语言规约上运作”,而且根本不瞄准任何证明器。论文对此毫不含糊:”FM-Agent 生成的规约无法被这些工具使用,因为那些工具针对的是形式规约而非自然语言规约。”流水线里没有 Lean,没有 Rocq,没有 SMT。神谕是一个语言模型。
这丢掉了确定性。问题是它换来了什么。
粒度比语言更要紧
这个想法的糟糕版本,是把一段长论证交给模型,问它对不对。长论证招来的是浮皮潦草的同意。你让一位读者去批准六十个段落,他会批准它们。
所以别那么问。把论证切成足够小的步子,每一步只是一次被认可的推理,然后去检查这些步子。
哪些推理?并不存在一份封闭的清单,假装有才是错的,因为人的推理不是从一个有限字母表里长出来的。有演绎、归纳、溯因;有贝叶斯更新、因果推理、模态与时序论证、类比。这里没有任何东西是关于人类如何思考的理论。
真正的主张要窄得多。这些模式里有少数几个被翻检得足够久,以至于我们清楚地知道它们何时成立,而直言三段论是其中被翻检得最彻底的一个。两条前提,一条结论,三个词项。所有 A 都是 B;所有 B 都是 C;所以所有 A 都是 C。共有 256 种句法形式,其中 24 种在传统上有效,若你不肯假定那些类是非空的,则是 15 种。最后这半句值得停一停:即便在人类写下过的、被推敲得最狠的逻辑里,有效形式的数目仍然取决于一条你必须明说出来的语义约定。一个建立在自然语言推理之上的系统会不断撞上这类接缝,而它正是要从接缝处裂开的。
实践中,这份目录大约有十来条。巴巴拉与肯定前件、否定后件并列,还有选言三段论、合取与简化、分情形、带假设的归纳,以及,既然对象是程序,霍尔的推论规则与顺序组合。它并不声称完整。要紧的是每一条都有事先定好的有效性条件,因此检查一步,意思是问它是否套进了某个已知形状,而不是问它听起来是否有说服力。粒度才是真正的设计决策:一个三段论大小的步子,小到足以被判断,又大到值得被记下来。
一个动作,四套戏服
小步子只有能组合才算数,而那条组合规则,原来是我们用不同的字母表写了两千年的同一件事。
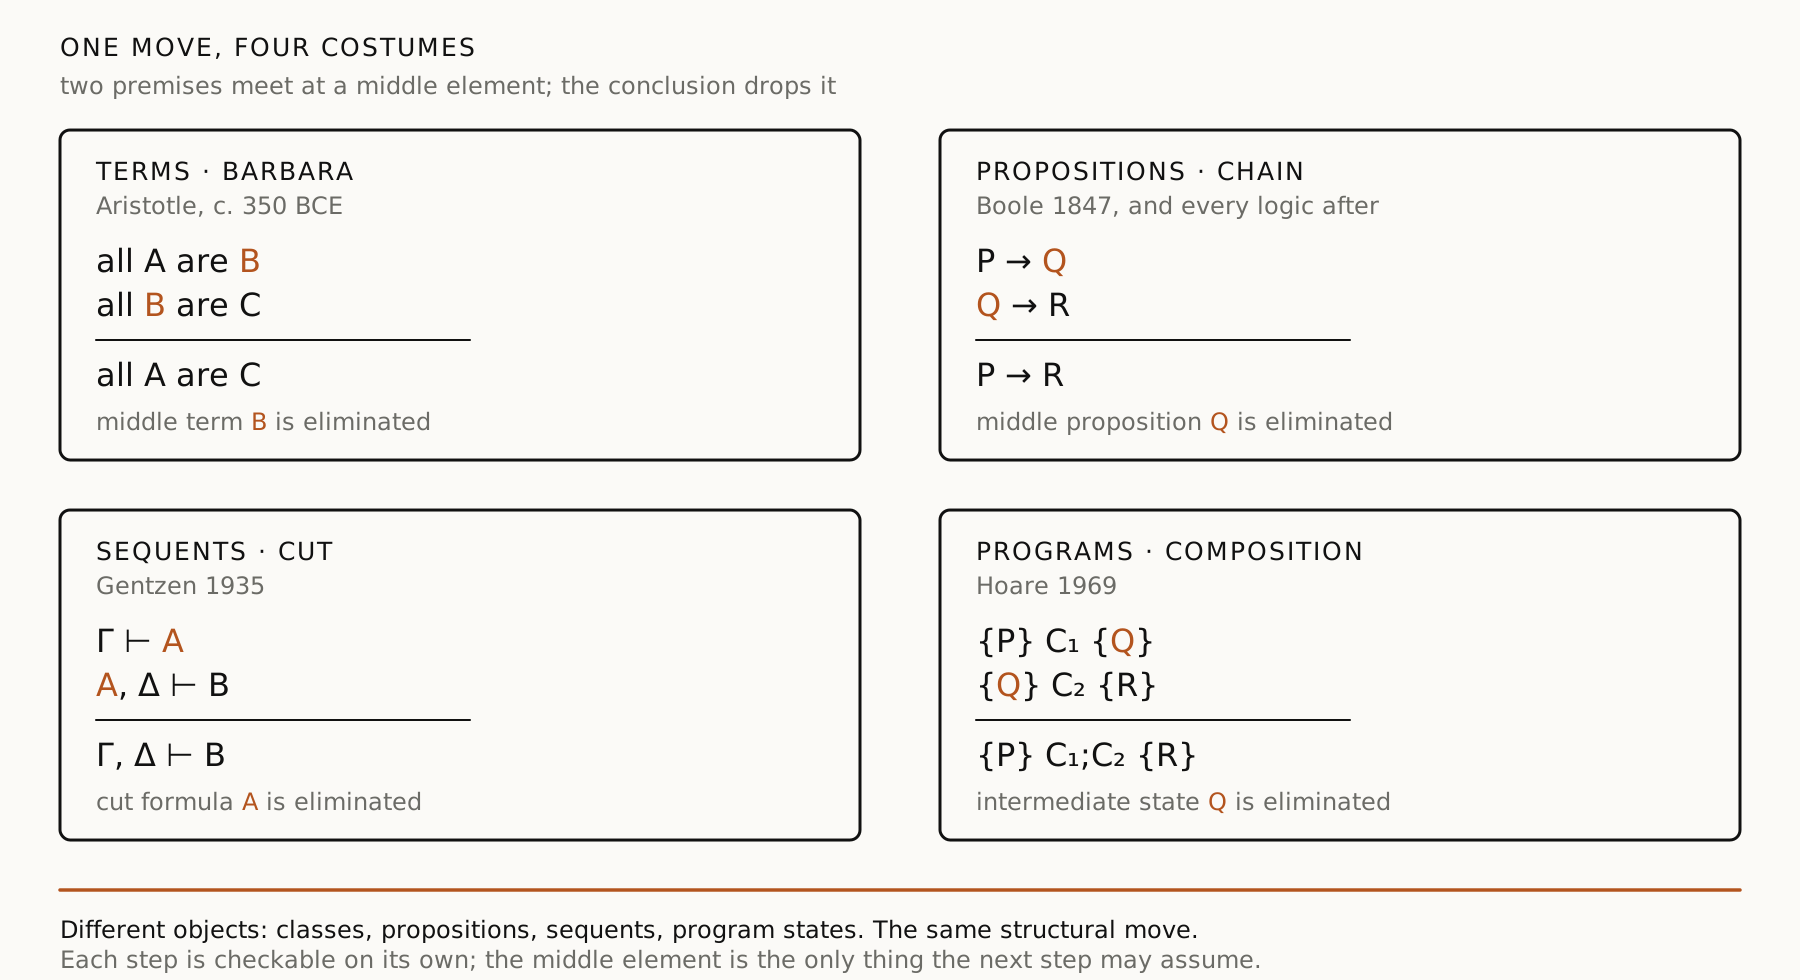
在巴巴拉里,中项连起主项与谓项,随后从结论中消失。在命题逻辑里,P 蕴含 Q 与 Q 蕴含 R 推出 P 蕴含 R,Q 不见了。在根岑的相继式演算里,这个动作叫作切,而那个消失的公式就以它命名。在霍尔逻辑里,一个把 P 带到 Q 的程序与一个把 Q 带到 R 的程序组合起来,其中的 Q,也就是机器的中间状态,正是前者交付的、后者要求的,也是组合之后只字不提的。
四类对象:类、命题、相继式、程序状态。一个结构性动作——我后来习惯把它叫作穿着四套戏服的切规则。正是这条性质,让局部检查能够累加。如果每个节点都写明自己的输入和输出,并且每个都能被单独判断,那么整段论证的正确性就成了这张图的性质,而不是某个人一口气读到底的耐力的性质。接线不过是普通的数据校验;检查它不需要任何模型读懂哪怕一句话。
你在拿什么换什么
形式推理作用在真值上。它的裁判是一个判定过程。它的失败方式是超时、撞上不可判定的片段,或者被塞进一个谁也写不出来的公式。但它说是的时候,它是对的。
基于词元的推理作用在句子上。它的裁判是一位读者,而它的失败方式是读错:被说服,被略读,或者认可了一个行文流畅、却并不跟从的步骤。它说是的时候,它大概是对的,而”大概”不是你靠调提示词能抹掉的东西。
形式那一侧底下有一道梯度值得点名。三段论逻辑是可判定的,布尔可满足性是 NP 完全的,一阶谓词逻辑是半可判定的,而霍尔逻辑干脆不可判定——所以相对完备性才是天花板。每上一级,都是用可处理性换表达力。
词元逻辑并不是这架梯子上的下一级。它是走下了这架梯子。并不存在一个叫作一位称职读者同意的复杂度类。它买到的不是一块更大的可判定片段,而是把前提说出口的能力:”窗口里永远不会出现重复字符”,”这个缓存是一致的,因为同一行不会在两处同时为脏”,”这次重试是安全的,因为这个操作是幂等的”。真实的系统论证正是由这样的句子组成的,而其中大多数没有谁会去写出一份形式化。
那一步没被检查的,住在哪里
形式验证同样不是无条件的,而这部分比较通常会被略过。
它的保证依赖于一次翻译——从你的本意,到你写进逻辑里的东西——而没有任何东西检查那次翻译。它就是规约:每一个被验证的系统最顶上,都是某个人读过并相信了的一段话。这不是假想。近来关于自动形式化的工作一再发现,同一个问题的形式陈述与非形式陈述彼此不符,而且在 miniF2F 中超过一半的题目上如此——那是一套由简短干净的数学陈述构成的基准,已经是翻译能遇到的最容易的情形了。
所以问题不是简单的可靠与不可靠。问题是你把那一步没被检查的自然语言放在哪里。形式化方法把它放在最顶上,只放一次,放在规约里,然后精确检查它底下的一切。基于词元的方法把它摊到每一步上,再近似地检查每一步。
前者给出的是关于某句可能很难检视的陈述的强保证。后者给出的是关于一些人读得懂的陈述的弱保证。两者谁也压不倒谁。你想要哪一个,取决于让你睡不着的到底是规约之下的一个微妙错误,还是规约之上的一个错误想法。
相对完备性,相对于一位读者
库克的定理让霍尔逻辑相对于一个”所有真断言”的神谕而完备——那个神谕不可能存在,理由比计算机还要古老,而五十年来我们一直在用求解器逼近它。
词元逻辑做的是同一次替换,只是换了一个神谕:一位称职的读者。这一个同样不可信,但理由完全不同。它不是不可计算,它是有时候会错。而且与前一个不同,你可以廉价地向它发问,问任何你说得出来的事,想问多少次都行。
于是下一个问题成了经验问题,而不是哲学问题。这位读者多久失手一次,在哪里失手,你能不能造出把这些失手兜住的东西?这正是最后一章要谈的。
参考文献
- C. A. R. Hoare. An Axiomatic Basis for Computer Programming. Communications of the ACM 12(10), 1969.
- Gerhard Gentzen. Untersuchungen über das logische Schließen. Mathematische Zeitschrift 39, 1935.(切规则,以及它的消去。)
- Stephen A. Cook. Soundness and Completeness of an Axiom System for Program Verification. SIAM Journal on Computing 7(1), 1978.
- Azim Ospanov, Farzan Farnia, and Roozbeh Yousefzadeh. miniF2F-Lean Revisited: Reviewing Limitations and Charting a Path Forward. arXiv:2511.03108, 2025.
- Haoran Ding, Zhaoguo Wang, and Haibo Chen. FM-Agent: Scaling Formal Methods to Large Systems via LLM-Based Hoare-Style Reasoning. arXiv:2604.11556, 2026.