白纸黑字的两块芯片
把 H100 的张量核心和 Trainium 2 的矩阵单元写成规约,以及其中那个偏向零的
一门描述算术的语言,在描述一块真实的芯片之前,都只是词汇。这一章用上一章的语言写下 H100 和 Trainium 2 的矩阵单元,让它们并排运行,再顺着一个发现追到它的后果。
“fp32 累加”的两种说法
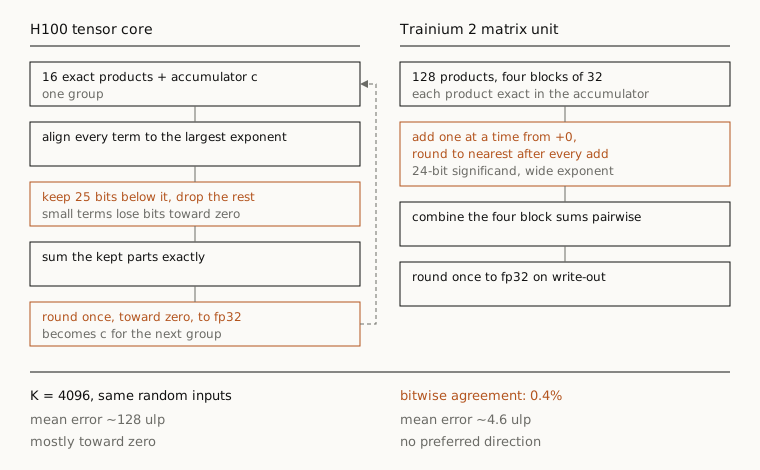
H100 的张量核心以十六个乘积为一组来处理 bf16 点积。每个乘积都是精确的。这一组,连同作为额外一项的累加器,对齐到组内最大的指数。每一项都被截到这个指数下方 25 位宽的窗口里,保留下来的部分精确相加,结果向零舍入一次,得到 fp32。然后开始下一组。
Trainium 2 的矩阵单元做的是完全不同的事。它把求和分成四个 32 项的块。块内一次加一项,每加一次就舍入到最近偶数,累加器的精度与 fp32 相同,指数更宽。四个块和两两合并,最后舍入到 fp32 一次。
每种描述在这门语言里都只有几行,并排一放,差别是种类上的。H100 很少舍入,而且向零舍入,舍入前先把各项截到一个窗口里。Trainium 每次加法都舍入,舍入到最近,没有窗口。两者在各自的文档里,都被描述为 fp32 累加的 bf16 矩阵乘。
黑盒怎样变成宏
这些都没有厂商文档,所以每一种描述都得从硬件里还原出来。H100 这边,先前的工作已经做了不少:MMA-Sim 逆向了 NVIDIA 的矩阵单元,提出了窗口宽度、组大小和舍入模式。这个项目没有对这些参数照单全收。
它把它们扫了一遍。窗口宽度从 23 到 27 位,组大小 4、8、16、32,向零舍入或舍入到最近偶数:四十个候选模型,每一个都在真实的 H100 上对着链式点积运行。恰好只有一个 100% 吻合所有输出:25 位窗口,十六个一组,向零舍入。第二名,26 位窗口,在普通输入上吻合 94%,在指数分散的输入上吻合 50%。
第二名和第一名同样重要。它说明这种比较能把两个相近的模型区分开,所以 100% 的吻合是有意义的。扫描一个参数空间、要求唯一的精确吻合,这个过程就是把黑盒变成宏的通用方法。Trainium 此前没有任何模型,所以它的宏来自新的探测,随后又对着二十多亿个硬件输出做了检查,零不一致。
每一次,都向零
我想追的发现是这个:H100 的张量核心向零舍入。一次舍入误差很小,最多是末位的一个单位。一个 4,096 项的点积要舍入几百次。舍入到最近时,误差有正有负,大体相互抵消。向零舍入时,误差都指向同一个方向,于是累积起来。
窗口让情况更糟。把一项截到窗口里,总会让它的绝对值变小。在长点积里,累加器会长到一个典型乘积的很多倍,从那以后它就是每一组里最大的那一项,于是每一个乘积都对着它被截断。
在 K = 4,096 时的实测结果:H100 的平均误差约为末位的 128 个单位,大多数误差指向零。Trainium 的平均误差为 4.6 个单位,没有偏好的方向。两块芯片在精确比特上一致的情形占 0.4%。
显而易见的读法在这里出了错。Trainium 的算术比另一个准确一个数量级以上,但这不等于”Trainium 跑 NVIDIA 训练的模型跑得更好”。一个在 H100 上训练的模型,是在 H100 的偏差下训练出来的,而 Trainium 不会复现这个偏差。这对模型质量是否要紧,是一个经验问题,没人能靠盯着误差统计回答它。它需要这整件事为之而建的那个实验:在 Trainium 上精确重放 H100 的算术,剩下的差距就可以归到别的原因上去。
宏是一个假设
从硬件里还原出来的描述,是关于硬件的一个断言,所以这门语言让每条描述都说明自己的证据有多强。每个指令宏都带着一条来源记录:有文档、经探测,或穷举验证。十亿个吻合的输出是一个很强的经验断言,但它仍然不是证明。对一个单参数 fp32 函数的全部 2³² 个输入做穷举检查,就是证明,对所测的那个配置而言。一份规约的信任基础,是它用到的所有经探测记录的清单,检查器可以把它打印出来。
穷举的形式,就是这门语言处理那些没人写得出来的函数的办法。Trainium 的 exp 在超过 3% 的输入上误差大于末位一个单位,用的算法没人还原出来,但规约仍然可以精确地叫出它的名字:一张以哈希值标识的查找表。
内核由这些宏搭成,一份内核规约就是每个输出一个表达式。把它们写下来,总会发现点什么。Trainium 的 RMSNorm 的第一版规约,在正常数据上与硬件吻合,在极端输入上却失败了。原因是一条指令:Trainium 的某个乘法对一切零结果都返回 +0,而 IEEE 754 说负数乘以零得 −0。比特不同。给这条指令单独写一个宏之后,RMSNorm、softmax、SwiGLU 和一个 GEMM 都与各自的规约吻合,零不一致。一份”基本正确”的规约,恰恰会把这些情形藏起来,而它们正是这项研究关心的情形。
两家厂商都管它叫 fp32 累加。写下来,它是两个不同的函数,而其中一个是偏的。
参考文献
- Peichen Xie, Shuotao Xu, Yang Wang, Fan Yang, and Mao Yang. Bit-Accurate Modeling of GPU Matrix Multiply-Accumulate Units: Demystifying Numerical Discrepancy and Accuracy. arXiv:2511.10909, 2025.
- Bit-Exact Field Guide, chapters 4, 7 and 9. 2026.