立此存照
给 AI 的证据树:先承诺一切,再检查你所选择的,只读那些没有机器能担保的部分
我交给智能体一项任务。过了一会儿,它说做完了。我怎么知道?
举一个小例子:写一个正确的数组排序函数。版本一,智能体回复“已完成,已测试”。版本二,它写代码,写测试,运行测试,把输出与排好序的数组应有的样子比对,然后报告每项检查都通过了。
几乎所有人都更信任版本二。可每一步都是同一个智能体做的。测试可能形同虚设,运行可能是编的,比对可能只是一句断言。如果智能体在版本一里会出错或撒谎,它在版本二的每一步里也会。那么,为什么版本二让人觉得更可靠?这种直觉是对的,而它为什么对,告诉了我们该如何为 AI 构建问责,而不是寄希望于它。
不是更可信,而是更可查
人也会犯错,而我们从来不是靠找到不犯错的人来解决这个问题的。我们安排工作,让错误留下证据。版本二做了版本一没做的三件事。它把一个论断拆成更小的论断:“代码是正确的”很难查,“这个测试覆盖了空数组”很容易。其中一些论断是执行,而一次计算可以由别人重新运行。这些步骤还会留下产物,一个测试文件、一份运行日志,它们独立于智能体对它们的描述而存在。
这些都不会让智能体更讲真话。它改变的是撒谎的代价。一句假的“做完了”只花一句话。一个假的版本二,需要一个测试文件、一份日志,以及彼此一致、又与代码一致的输出,还要经得住我事后选择的任何检查。信任跟随的不是智能体做了多少工作,而是其中有多少我能检查、检查起来有多便宜。
先承诺,再检查
我事后选择的任何检查,正是默克尔哈希树派上用场的地方。每个节点存储其子节点的哈希,于是一个很短的根值就承诺了整个结构;改动任何地方,根都会变。Git 就是这样工作的,让网站证书签发可审计的公开日志也是。
对智能体产出的每一个产物做哈希,再把每一个论断连同它所依据的哈希一起做哈希。智能体在我选择打开什么之前,就交出根哈希。这样抽查才有意义:智能体伪造的任何一步都必须事先伪造好,而我打开的每一步,只要与它的承诺不符,就会被抓到。随机抽样变成了一次可以计算胜算的审计。
哈希证明的是我看到的就是被承诺的内容,而不是它是对的。一个论断对不对,取决于这个节点记录的是哪一类步骤。
三类节点
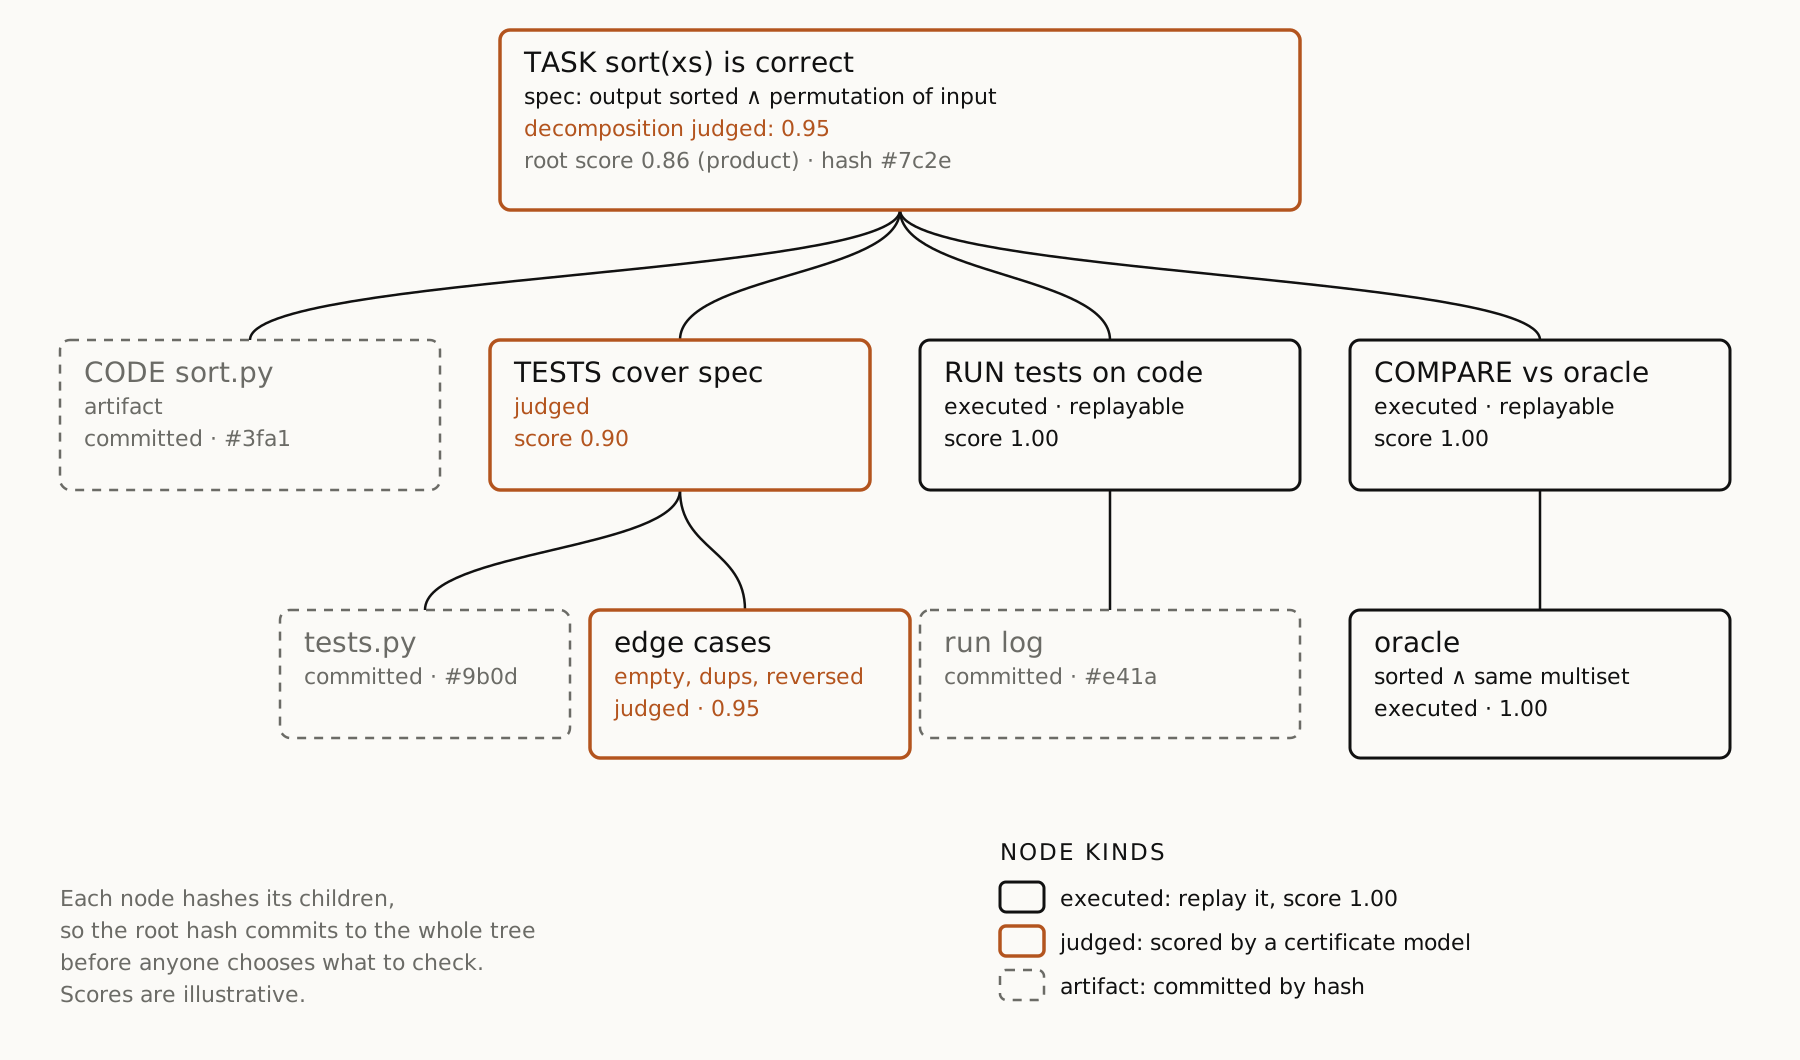
执行节点记录一次计算:在这份代码上运行这些测试,把这些输出与这个判定器比对。任何人都可以从已承诺的输入出发重放它们,所以它们的可信度实际上是 100%。它们不涵盖的,是这次计算从何而来:运行测试的脚本是智能体写的,所以“这个脚本运行的是这些测试”是一个判断类论断。运行它则不是。
判断节点记录没有计算能解决的论断。这些测试覆盖了“排好序”的含义吗?智能体想到重复元素、空数组、逆序输入了吗?一个独立的证明模型阅读任务、产物和论断,给出一个可信度分数。它必须独立于智能体,权重不同,除了已承诺的产物别无依据:给自己的代码写测试的智能体,有着与自己相同的盲点。而且它的分数是判断,不是证明;语言模型作为逐步判官仍不可靠(见《它管用吗?》)。
给定节点是规格说明:“输出是有序的,并且是输入的一个排列。”没有人检查它,因为它定义了任务。必须有一个人读过它,并认同这就是他想要的。
根是人的任务,子节点是子任务,每个节点带着它的类别和分数。分数按乘积合成,所以一个薄弱环节会拖低它之上的一切。
人读什么
没有人读整棵树。人读的是规格说明,以及少数几个低分节点。其余的要么由机器重放,要么由独立模型打分,要么对照事先作出的承诺被抽查。
机器检查的证明早已如此:你信任的是一个小小的检查器和顶端的那条陈述,而不是写证明的人。而且每一个经过验证的系统,顶端仍有一段某人读过并相信了的文字。不同之处在于,证据树由人能读懂的步骤构成,所以失败会落在一个有名字的节点上。
当树大到读不完
一棵排序的树只有几个节点。移植一个大型系统、或者智能体一周的工作,对应的树有成千上万个节点,“读低分节点”仍可能意味着几百个。读这棵树本身成了一项任务。那就把它当作任务:交给一个智能体,并要求它给出一棵证据树。
诱人的请求是“总结一下这棵树”,而这恰恰是错的。一份取代证据的总结,可能会把那唯一一个坏节点淹没在“大体没问题”里。要问一个更窄的问题:以根哈希 h 承诺的树 T,是否支持论断 R?它的例外在哪里?
这个问题有一个有用的性质。它的大部分是对已承诺数据的计算。每个执行节点都能重放吗?每个哈希都对得上吗?哪些判断节点得分低于 0.9?这些都是在树上运行的程序,所以在新的树里,它们是执行节点,任何人都能重放。仍需判断的部分很小:例外本身,以及界定“例外”的阈值,而阈值归人来定。关于这棵树的树,大部分是执行;只有例外向上攀升。
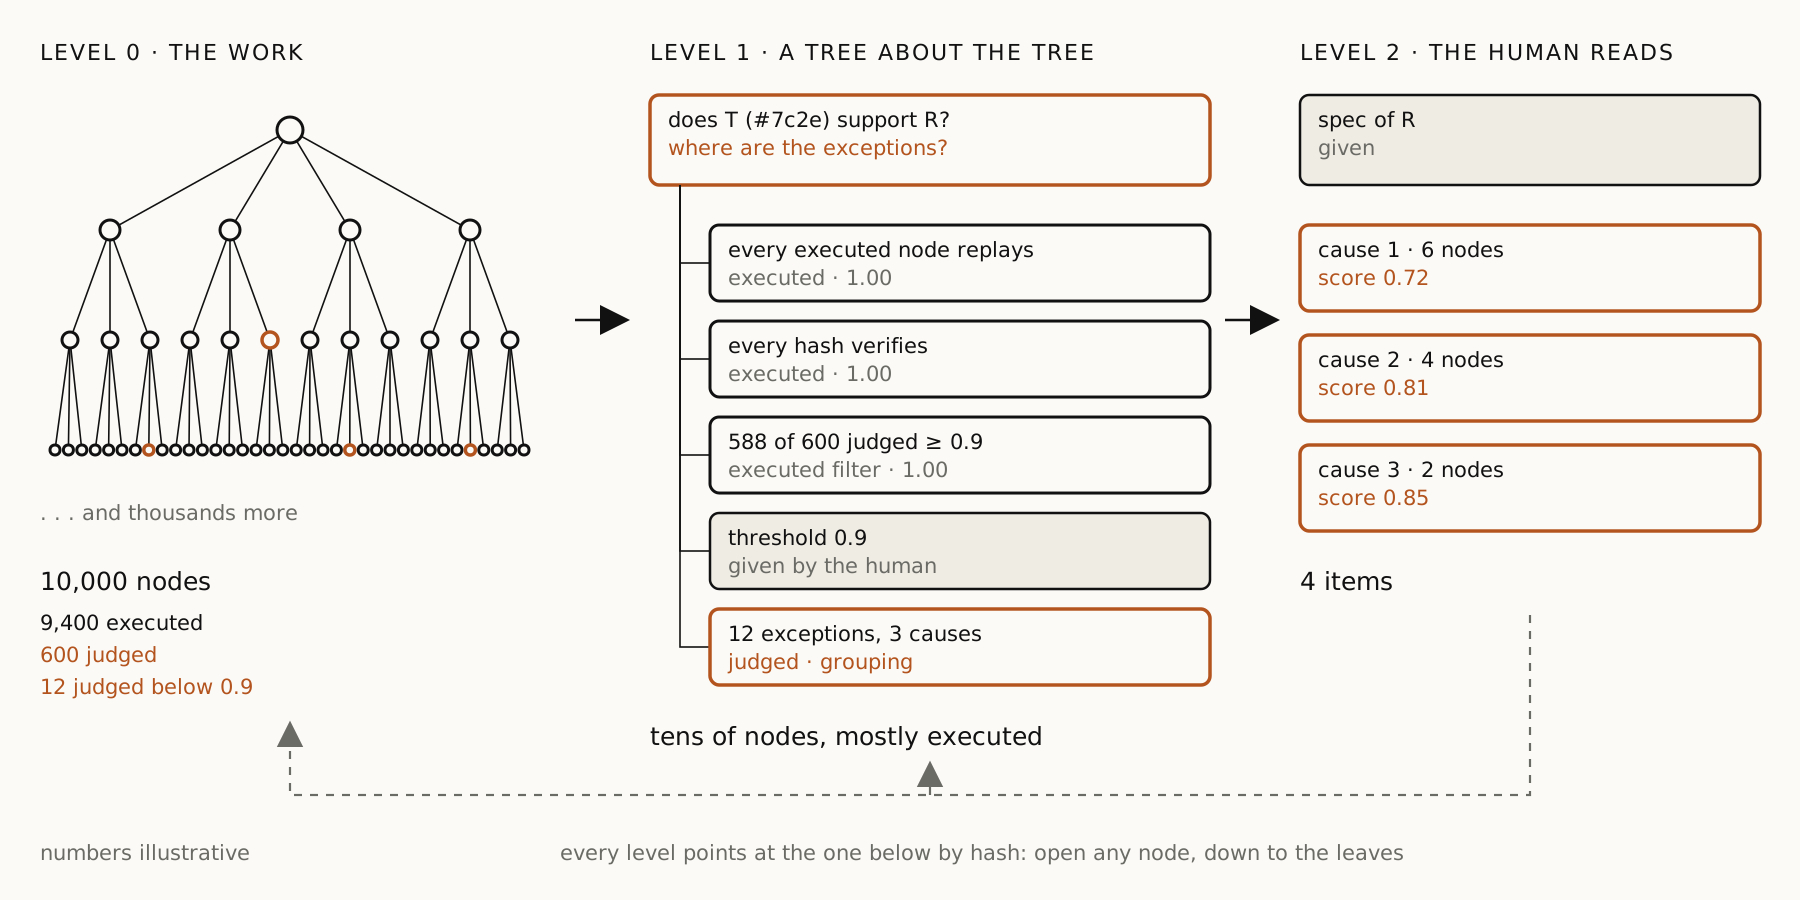
重复这个过程,每一层都比下一层小,因为聚合的结果检查起来很便宜,而如果工作做得好,例外就很少。等剩下的东西能装进一个人的注意力时就停下:规格说明,加上几个没有机器能担保的节点。每一层都通过哈希指向下一层,所以人仍然可以打开任何一个叶子。嵌套缩小的是你必须读的,而不是你能检查的。组织早就这样运作:审计师不会读每一张发票;她测试内控,抽样,然后报告例外。
这也有一个限度,而这个限度本身很有信息量。只有当判断稀疏时,嵌套才会收敛。如果原始工作的大部分都是判断,每一层都会把同样不确定的论断原样往上转交,什么也缩不小。这不是方法的失败,而是一次测量:证据无法被压缩的工作,就是我们还无法带着问责去委托的工作,它标出了人仍须亲自思考的地方。
留下证据
几十年前的携带证明的代码(proof-carrying code)就是同样的经济学:生产者构建证据,代价高;消费者检查证据,代价低。AI 让生产者那一侧几乎免费,所以我们应当向它要得更多。
版本二是对的直觉,只是只建了一半。不要问智能体是否可信。要它交出一棵你能拿来追责的树:每个产物都已承诺,每次计算都可重放,每个判断都由别人打分,而顶端小到读得完。AI 的问责不会来自永不出错的 AI,而会来自一出错就必然留下证据的 AI。
参考文献
- Ralph C. Merkle. A Digital Signature Based on a Conventional Encryption Function. CRYPTO 1987.
- George C. Necula. Proof-Carrying Code. POPL 1997.
- Ben Laurie, Adam Langley, and Emilia Kasper. Certificate Transparency. RFC 6962, 2013.