近水楼台
系列「太阳底下无新事」第三篇——局部性,最古老的性能诀窍,和它总会寄来的一致性账单
这是一个系列的第三篇,讲计算机科学一再以新名字重新发现的那些想法。前两篇是去重和搜索。这一篇比两者都老,简单得不像一条原则:让数据靠近使用它的地方。我越来越相信,性能工程的大部分,都是这一个想法在新的距离上再用一次。
性能,大半是地理
原因在物理。信号穿过导线不可能快过光,而在 3 GHz 时钟的一个周期里,光大约走十厘米。真实的片上导线比这慢得多,因为它的延迟随长度的平方增长。所以距离就是时间。距离也是能量:在 45 纳米工艺的芯片上,一次 32 位浮点加法约耗 0.9 皮焦,而从 DRAM 读出同样的 32 位约耗 640 皮焦。算术很便宜。把操作数搬到算术那里,才是要付钱的部分。
程序在这一点上待我们不薄。它们倾向于重用刚碰过的东西,也倾向于碰挨着的东西。Peter Denning 在二十世纪六十年代末把这叫作局部性。那时虚拟内存系统开始抖动,而他的工作集模型解释了原因:程序在任一时刻只需要一小组、缓慢变化的页面,把这一组放在近处,其余的尽可以放远。
同一招随后在每个尺度上重现。缓存把最近用过的内存放在核心旁边。二十世纪八十年代,Lisp 机器为一门由指针构成的语言造了专门的硬件:CDR 编码把一个列表的各个单元挨着存放,它们的垃圾回收器把相互关联的对象拷到同一页上,好让数据保持局部。到九十年代初,它们输给了通用工作站,后者跑 Lisp 一样快,甚至更快。
AI 内核是最新的一例。FlashAttention 没有改变注意力的计算。它改变的是中间结果住在哪里:不再把 N×N 的注意力矩阵写进 GPU 显存再读回来,而是分块计算,块始终留在片上 SRAM 里。GPT-2 的训练快了三倍。一般意义上的内核融合是同一笔交易:同样的算术,更少的往返。
这些都没有改变算的是什么。它们改变的是算的时候数据在哪里。
每一份副本都是一个承诺
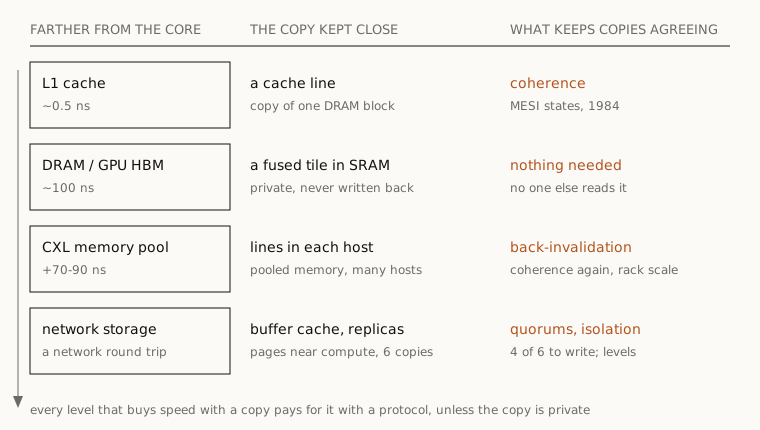
怎样让数据靠近?拷贝它。缓存行是一块内存的副本。副本节点是一个数据库的副本。缓冲池里的页是磁盘上一页的副本。而一旦有了两份副本,它们就可能不一致。
所以第二波总是紧随第一波。多处理器有了私有缓存,随即需要缓存一致性协议;MESI 的四个状态可以追溯到 1984 年。复制的服务需要一致性,线性一致性在 1990 年给了它定义。让事务读自己快照的数据库需要隔离级别,以及一场关于哪些异常可以接受的漫长争论。名字不同,问题是一个:局部性就是拷贝,一致性就是账单。
账单并不总是到期,而它何时不到期,本身就说明问题。FlashAttention 的分块不付任何代价,因为没有别人会读它们。它们是私有的,转瞬即逝。只读的副本也是免费的:一千个缓存可以持有同一个常量,不需要任何协议。账单恰好在数据被拷贝、被共享、又被写入时到来。由此得出一条简单到可以拿来检查设计的规则:拷贝没人写的东西;拷贝别人会写的东西,要小心。
故意把数据搬远
过去十年,云一直在做相反的事:把数据从计算旁边搬走。Amazon Aurora 把数据库引擎和它的存储分开;只有重做日志记录穿过网络,而存储在三个可用区里保存六份副本。CXL 内存池把 DRAM 从单台服务器里抽出来,因为多达四分之一的内存闲置搁浅,而内存可能占到服务器成本的一半。代价是距离:微软的 CXL 内存池设计 Pond 测得,每次访问要多出 70 到 90 纳秒。
为什么放弃局部性?为了利用率、弹性和故障独立,这些是局部性从来给不了的。而且一个远处的唯一真相,在一段时间里,比许多近处的副本更容易保持一致。
这段时间不会长久。Aurora 的计算节点仍然保留缓冲缓存,所以大多数读请求从不离开本机。CXL 3.0 让多台主机一致地共享池化内存,这意味着内存池可以反过来让主机缓存的行失效。解耦,延迟就逼你加缓存;加了缓存,副本就寄来账单。钟摆在局部性和唯一真相之间来回摆动,每一次摆动,都在更大的距离上重新发明上一次的协议。
我自己的一部分工作就在这里。当维持副本一致的协议复杂到无法信任时,你可以改为检查结果:记录客户端观察到了什么,然后问是否存在某个串行顺序能够解释它。这就是一致性检查,而它之所以存在,正是因为局部性不断制造副本。
上下文窗口就是缓存
现在看一个 AI 智能体。它的上下文窗口是它最快的存储,而它放进去的是副本:十分钟前读过的文件,上一次运行的测试输出,今早被告知的设计。选择把什么放进上下文,就是选择一个工作集。检索做得好的智能体,就是局部性好的智能体。
而它们的副本会过期。另一个智能体改了文件,一个人改了计划,这个智能体却还按自己的副本行事。只有一个智能体时,这只是恼人。许多智能体共享一个代码仓库时,这就是一个没有一致性协议的一致性问题。编辑文件前先重读一遍,就是手工失效。我预计多智能体系统会以某种形式重新发现整个第二波:所有权、失效,以及一场关于哪些异常可以接受的争论。
既要近,也要一致
“放近一点”只是规则的一半。另一半是知道还有谁持有副本。局部性让计算机变快,而一致性是共享那些被变快之物的代价。我不认为哪一半会消失。我预计下一个系统,无论在什么距离上工作,都会为两者再付一次。
参考文献
- Peter J. Denning. The Working Set Model for Program Behavior. Communications of the ACM 11(5), 1968. See also The Locality Principle, Communications of the ACM 48(7), 2005.
- Ron Ho, Kenneth W. Mai, and Mark A. Horowitz. The Future of Wires. Proceedings of the IEEE 89(4), 2001.
- Mark Horowitz. Computing’s Energy Problem (and What We Can Do about It). ISSCC 2014.
- David A. Moon. Garbage Collection in a Large Lisp System. ACM Symposium on LISP and Functional Programming, 1984.
- Tri Dao, Daniel Y. Fu, Stefano Ermon, Atri Rudra, and Christopher Ré. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. NeurIPS 2022.
- Mark S. Papamarcos and Janak H. Patel. A Low-Overhead Coherence Solution for Multiprocessors with Private Cache Memories. ISCA 1984.
- Maurice P. Herlihy and Jeannette M. Wing. Linearizability: A Correctness Condition for Concurrent Objects. ACM TOPLAS 12(3), 1990.
- Alexandre Verbitski et al. Amazon Aurora: Design Considerations for High Throughput Cloud-Native Relational Databases. SIGMOD 2017.
- Huaicheng Li et al. Pond: CXL-Based Memory Pooling Systems for Cloud Platforms. ASPLOS 2023.
- CXL Consortium. Compute Express Link 3.0 White Paper. 2022.