重放归来
一套面向 AI 智能体的调试框架,以及它为何必须一路下探到内核
一个智能体昨天跑了某个任务,成了。今天跑同一个任务,它做了别的事。这两次运行,你该信哪一次?到底是什么变了?
眼下没人答得上来。所谓最佳实践就是:再跑一遍,然后祈祷。当模型只是写写诗的时候,这尚可忍受;如今智能体手里握着 shell 权限,就不能忍了。在我们自己的测量中,横跨 17 个模型、10 个系统管理任务,通过率动辄超过 80%,但同一个任务的两次运行,在”改动系统状态的那串动作”上达成一致的概率,只有大约 39%。我们也见过仅仅因为一个时钟就分道扬镳的运行:同样的任务,同样的模型,只是环境里可见的时间戳不同,智能体便走上了另一条路。
这对系统研究者来说并不新鲜。它有个名字,叫非确定性,而系统社区已经跟它缠斗了几十年。今天不同的地方在于:AI 这套技术栈,把非确定性在许多层上同时放大了。
非确定性的三个层次
与传统系统不同——在那里,非确定性往往被关在某个抽象层之内——在 AI 技术栈中,它可以悄无声息地向上传播,影响更高的层次。
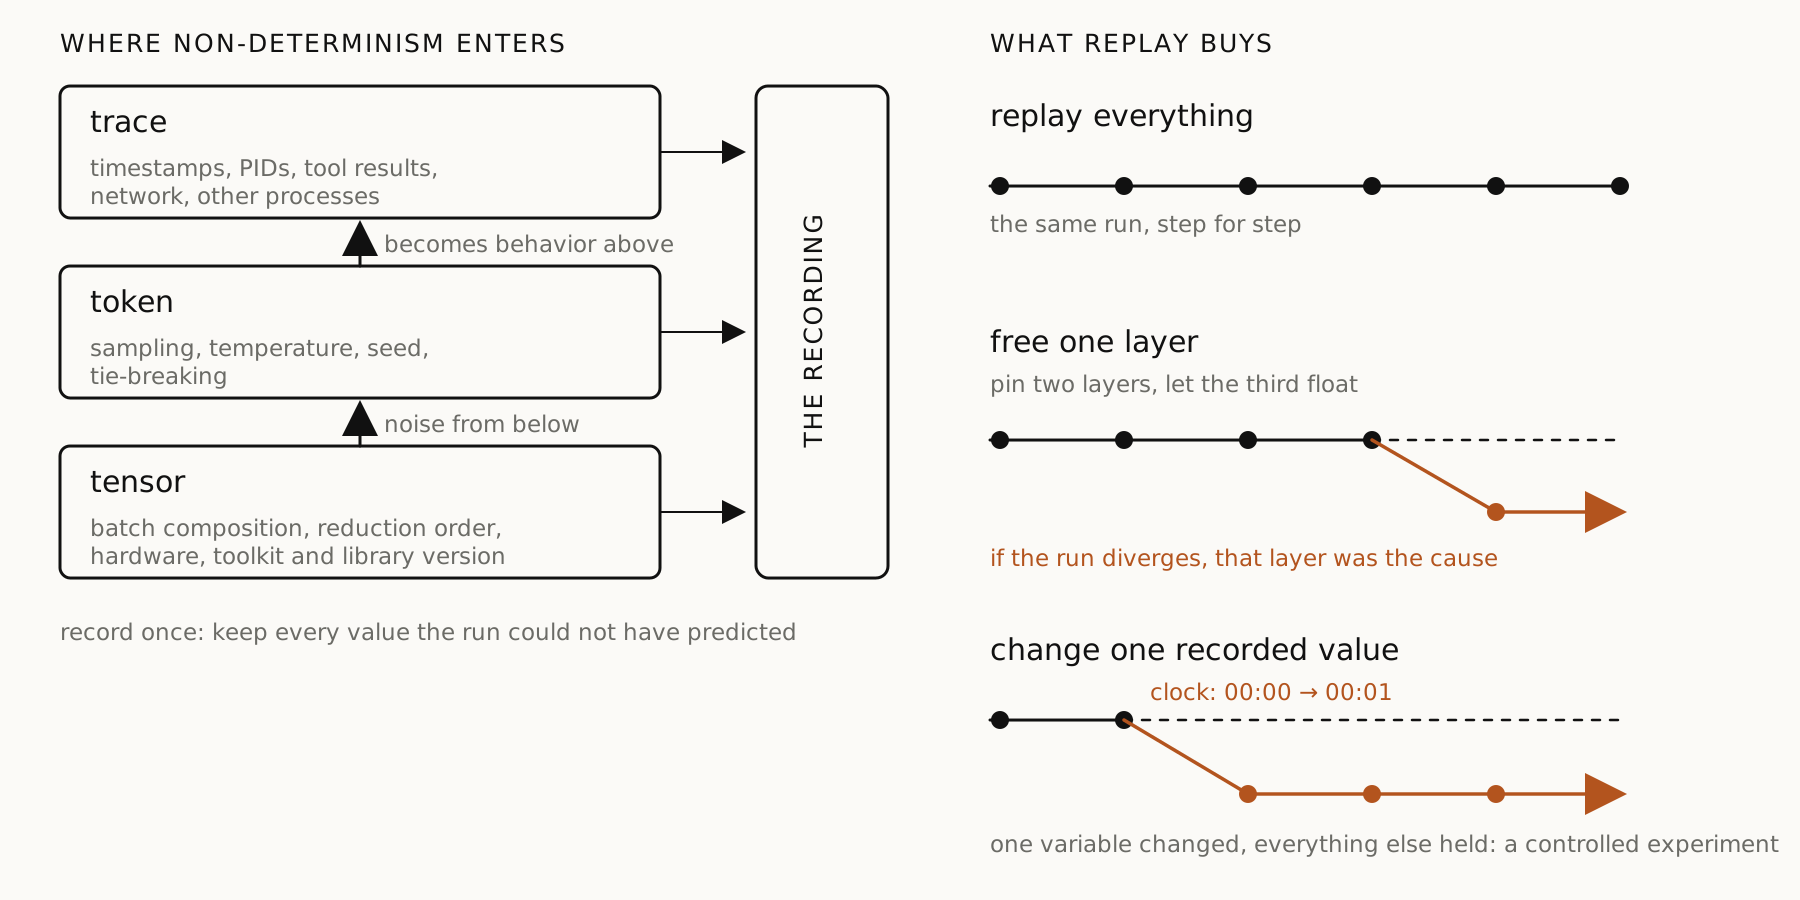
张量层。 算术本身。多数推理内核不具备批不变性:归约的做法会随着同时成批处理的请求数量而变化,于是一个请求的输出,取决于它抵达那一刻服务器的负载。批不变内核可以消除这种波动,代价是大约 1.6 倍的延迟。再往下,是那些更缓慢的漂移——换一块 GPU,换一个库版本——厂商对此毫不含糊:cuBLAS 只承诺在相同架构、相同 SM 数量的 GPU 上逐位可复现,而跨工具链版本从不承诺。
词元层。 采样。温度、top-p,以及从分布中抽样的那个随机数发生器。这一层是人人都知道的一层,也是唯一有面向用户旋钮的一层——而即便这个旋钮也很弱:seed 参数在文档里被写成一个”尽力而为”的承诺,确定性”不作保证”,而且它正在被废弃。
轨迹层。 外部世界。时间戳、PID、文件列表、网络响应、工具输出,以及两次运行之间别的进程对这台机器做过的任何事。这一层有一个另外两层不具备的性质:智能体会改变它。运行本身,会修改下一步要读的状态。
再者,这些层会向上叠加:归约里一个不同的舍入取舍,变成一个不同的词元,变成一条不同的 shell 命令,变成一串不同的动作序列。底层的噪声,就是顶层的行为。这也正是为什么,面向智能体的调试器不能只待在框架这一层。
TTTR:记录、重放,以及操纵
TTTR 即张量-词元-轨迹级重放(Tensor-Token-Trace-level Replay):把一次运行在三个层次上的非确定性全部记录下来,然后重放它。
记录。 把这次运行无法预知的每一个值都抓下来——张量层的批组成或内核输出,词元层采样出的词元与种子,轨迹层的时钟、PID 与工具返回结果。这是个有着悠久系统血统的老想法:ReVirt 记录在一个不可信操作系统之下,R2 让程序员自己选择在哪里切一刀,而 rr 把记录重放做到了便宜得可以天天用。
重放。 把它跑回来,得到同一次执行。这里,经典文献给出了一个值得听取的警告:ODR 干脆放弃了复现完全相同的执行,只保证相同的输出,因为推断出一个精确的调度代价高得离谱。对智能体而言,逐位相同的重放同样是个错误的标准。你真正想要的,是一次能抵达相同决策的重放。
选择性重放。 这才是整件事的意义所在。钉住两层,放开第三层。或者忠实地重放一切,只改动一个记录下来的值——把时钟拨快一秒,塞回一个不同的工具结果,翻转一个采样出的词元——然后看轨迹在哪里分叉。系统领域的先例是”可变重放”:拿一份录制去重放被修改过的代码;TTTR 把它从”改代码”推广到”改任何一个非确定性来源”。而且它让 delta 调试——Zeller 那套二分搜索出最小致错改动的方法,出自题为《昨天我的程序还好好的。今天它不行了。为什么?》的论文——变成一件可以跨层施行的事,而不再局限于单一输入之内。
拿它能做什么
定位到层。 智能体昨天好好的,今天失败了。用昨天记录的值钉住张量层来重放今天这次运行:如果失败消失了,那是算术在你脚下移动了。改为钉住轨迹层:如果失败消失了,那是环境变了。这种分诊今天并不存在,而它回答的,正是每一个值班工程师真正想问的问题——不是”智能体做了什么”,而是”到底哪里不一样”。
做反事实实验。 只改一件事,其余全部按住。如果那个端口本来就是空闲的,智能体还会去杀掉那个进程吗?这个任务依赖日期吗?今天,这类问题只能靠轶事和重跑来回答,而重跑会同时混淆所有变量。重放把它们变成只有一个自变量的受控实验。最近有一篇关于智能体失败归因的预印本用统计方式做这件事:对某一步施加干预,然后重新采样;而一套重放系统,能让你以机械的方式做到,既更便宜,也更锋利。
给出诚实的数字。 通过率把这篇文章所讲的一切都藏了起来。有了重放,你可以钉住下面几层,去测量一个基准测试上的差异中有多少来自模型、多少只是噪声——也就是给智能体评测做一次方差分解。如果同一个智能体的两次运行,在”做了什么”上只有 39% 的一致率,那么两个百分点的基准差异什么也说明不了。
确定性从来都是造出来的
确定性从来不是计算机与生俱来的性质。它是被建造出来的,代价不菲,然后被每一个用过调试器的人安静地依赖着。线程侵蚀了它,而记录重放这一脉文献花了几十年把它赢回来。如今,智能体又一次把它拿走了。
我们正走在把确定性找回 AI 的路上。而这一次,回报还不止于调试:造出批不变内核的那群人发现,一旦推理变得确定,他们的强化学习就真正变成了 on-policy 的,采样器与训练器之间的散度稳稳地贴在零上。一个可重放的系统,就是一个可检查的系统;而一个可检查的系统,就是一个你可以拿来训练的系统。我们把可复现性丢掉的那一刻,恰恰是我们开始运行那些行为无法预知的程序的那一刻。
参考文献
-
Tian Lu, Zikai Wang, and Cheng Tan. Beyond Pass Rate: A Hierarchy of Behavioral Consistency for LLM Agents. SCCP 2026.
-
Horace He and Thinking Machines Lab. Defeating Nondeterminism in LLM Inference. Thinking Machines Lab: Connectionism, September 2025.
-
NVIDIA. cuBLAS: results reproducibility and Floating Point and IEEE 754 Compliance for NVIDIA GPUs.
-
George W. Dunlap, Samuel T. King, Sukru Cinar, Murtaza A. Basrai, and Peter M. Chen. ReVirt: Enabling Intrusion Analysis through Virtual-Machine Logging and Replay. OSDI 2002.
-
Zhenyu Guo, Xi Wang, Jian Tang, Xuezheng Liu, Zhilei Xu, Ming Wu, M. Frans Kaashoek, and Zheng Zhang. R2: An Application-Level Kernel for Record and Replay. OSDI 2008.
-
Gautam Altekar and Ion Stoica. ODR: Output-Deterministic Replay for Multicore Debugging. SOSP 2009.
-
Nicolas Viennot, Siddharth Nair, and Jason Nieh. Transparent Mutable Replay for Multicore Debugging and Patch Validation. ASPLOS 2013.
-
Robert O’Callahan, Chris Jones, Nathan Froyd, Kyle Huey, Albert Noll, and Nimrod Partush. Engineering Record And Replay For Deployability. USENIX ATC 2017.
-
Andreas Zeller. Yesterday, my Program Worked. Today, it Does Not. Why? ESEC/FSE 1999. 另见 Zeller and Hildebrandt, Simplifying and Isolating Failure-Inducing Input, IEEE TSE 28(2), 2002.
-
Jaineet Shah. Causal Agent Replay: Counterfactual Attribution for LLM-Agent Failures. arXiv:2606.08275, 2026.